2026-09-05 · 人工看图核对 · 已判定
FT-DINOSAUR 的 7 个 slot 有没有把杯子分出来:已判定
耗时早就实测过关(52.4 ms,预算 337 ms),但项目纪律是 感知类结论必须过人工看图。2026-09-05 操作者看完全部 12 帧, 判定是:「杯子大部分时候都有被识别,只是有时候会跟右手抓夹识别成一片」。 随后独立算出的数字和这个判读完全吻合——见第 3 节。结论:B0 的输入端成立,但要按阶段理解。
为什么这一步不能省:FT-DINOSAUR 是无监督的物体中心模型,
它不知道什么是杯子,只是把画面切成 7 块。切得对不对,没有任何指标能替代看一眼。
如果 7 个 slot 只是把画面按颜色糊成几片,那 52 ms 再快也没用。
1. 实测背景
52.4 ms
small@224 中位耗时p95 53.8 · 显存 152 MB · 本机 train310 实测 N=50
7 × 256
输出 slot数量固定,正好是 B0 要的形状
262 ms
small@518 中位耗时掩码分辨率 37×37 而非 16×16
?
slot 质量就是这一页要你判的
用的是 09-04 那 4 次试跑的 12 张关键帧(05-training/trials/keyframes/,424×240 真实头部帧)。
2. 要看什么(判据)
看每一帧的 7 个 slot,回答三个问题:
- 有没有某一个 slot 单独亮在杯子上?——这是最关键的一条。有,B0 的输入端就成立
- 那个 slot 是不是把杯子和夹爪糊在一起?——糊在一起也还能用(位置仍然对),但不如分开干净
- 跨帧看,杯子是不是稳定落在同一个编号的 slot 上?——不稳定不致命(策略可以自己学会挑),但稳定会好训得多
3. 判定结果:人工看图与测量互相印证
操作者看完 12 帧后的原话:
「杯子大部分时候都有被识别,只是会跟右手抓夹识别成为一片,有的时候。」
随后独立算出的两个数完全对上了这句话——这是这个项目里最强的一种证据: 两个独立的测量互相印证。
随后独立算出的两个数完全对上了这句话——这是这个项目里最强的一种证据: 两个独立的测量互相印证。
怎么把「有没有分出来」变成可核对的数
对每一帧,用 OWLv2 @0.30 定出杯子框(我们实测过 100% 精度的配置),然后算两个数:
| 定义 | 回答什么 | |
|---|---|---|
| 覆盖率 | 框内被判给该 slot 的像素 ÷ 框内总像素 | 这个 slot 盖住了杯子的多少 |
| 纯度 | 框内被判给该 slot 的像素 ÷ 全图属于该 slot 的像素 | 这个 slot 是不是专门管杯子的 |
★ 光看纯度会误判,必须先算基线 ★
7 个 slot 要瓜分整张图,平均每个占 14.3%;而杯子框只占画面 1.9%–3.4%。
所以一个「恰好平均大小、正好包住杯子」的 slot,纯度天然就是约 19%。
下表的「倍数」= 实际纯度 ÷ 这个基线:1.0× = 只是碰巧盖住,3× = 明显专注在杯子上。
逐帧结果(9 帧有杯子,3 帧没有)
| 帧 | 框占画面 | 基线纯度 | 224 主导 slot | 覆盖率 | 纯度 | 倍数 | 518 倍数 |
|---|---|---|---|---|---|---|---|
| t1-init | 2.7% | 19.0% | slot 2 | 94% | 55% | 2.9× | 2.9× |
| t2-init | 2.9% | 20.6% | slot 5 | 86% | 32% | 1.5× | 0.7× |
| t3-init | 3.4% | 23.6% | slot 2 | 71% | 76% | 3.2× | 0.6× |
| t4-init | 2.3% | 16.4% | slot 4 | 91% | 54% | 3.3× | 3.0× |
| t1-closure | 2.7% | 19.0% | slot 6 | 96% | 21% | 1.1× | 2.3× |
| t2-closure | 2.2% | 15.3% | slot 4 | 99% | 20% | 1.3× | 0.7× |
| t4-closure | 2.2% | 15.5% | slot 1 | 100% | 20% | 1.3× | 0.8× |
| t1-end | 2.4% | 16.8% | slot 3 | 68% | 32% | 1.9× | 1.2× |
| t4-end | 1.9% | 13.5% | slot 4 | 100% | 19% | 1.4× | 1.7× |
| t2-end · t3-closure · t3-end —— OWLv2 检不出杯子,不参与判定(见第 3.2 节) | |||||||
3.1 按阶段汇总——这就是「有时候糊成一片」的数字形态
2.7×
init(接近阶段)slot 明显专注在杯子上
1.2×
closure(合拢时)≈ 基线,摊成平均大小的一片
1.7×
end(提起后)68–100%
覆盖率范围,中位 94%杯子几乎总在某一个 slot 里
物理上完全说得通:init 帧里杯子独自立在桌上,容易切开;
closure 帧里夹爪已经压在杯子上,slot 自然把杯子 + 夹爪 + 手臂并成一块。
这正是操作者肉眼看到的现象。
3.2 ★ 一个关于试跑本身的发现(不是关于 FT-DINOSAUR 的)★
t3-closure 和 t3-end 里根本没有杯子。
也就是说第 3 次试跑夹爪合拢的那一刻,头部相机里看不到杯子。
t2-end 同样没有。
这条是操作者先肉眼看出来的,再由 OWLv2 独立证实(12 帧里 9 帧检出、3 帧无)。 它和 slot 质量无关,是关于那批试跑的独立线索—— 可能是手臂遮挡,也可能是夹爪合在了没有杯子的地方,后者和 0/3 吻合。
4. 分辨率不是瓶颈——这个猜测被推翻了
518(262 ms)并不比 224(52 ms)好,多数帧反而更差。
init 阶段平均 224 是 2.7×,518 只有 1.8×。
原先的猜测是「分不干净是因为杯子在画面里太小」。 这个猜测不成立:把掩码分辨率从 16×16 提到 37×37 没有让 slot 更专注。 所以 262 ms 那个选项可以直接划掉——又贵又不更好。
原先的猜测是「分不干净是因为杯子在画面里太小」。 这个猜测不成立:把掩码分辨率从 16×16 提到 37×37 没有让 slot 更专注。 所以 262 ms 那个选项可以直接划掉——又贵又不更好。
下面四张是同一帧的三联对照(原图 / 224 / 518),可自行核对:
5. 全部 12 帧(每帧:原图 + argmax + 7 个 slot)
用的是 224 模型(52 ms 那个)。点图可放大。
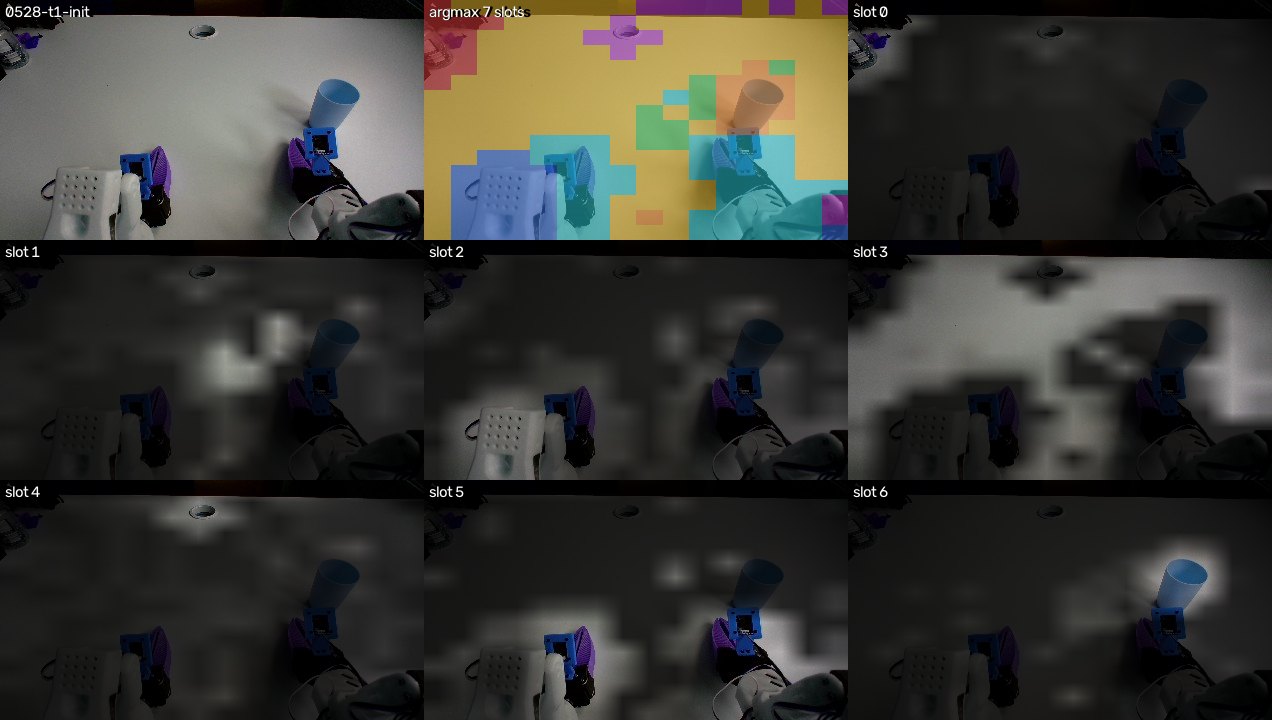
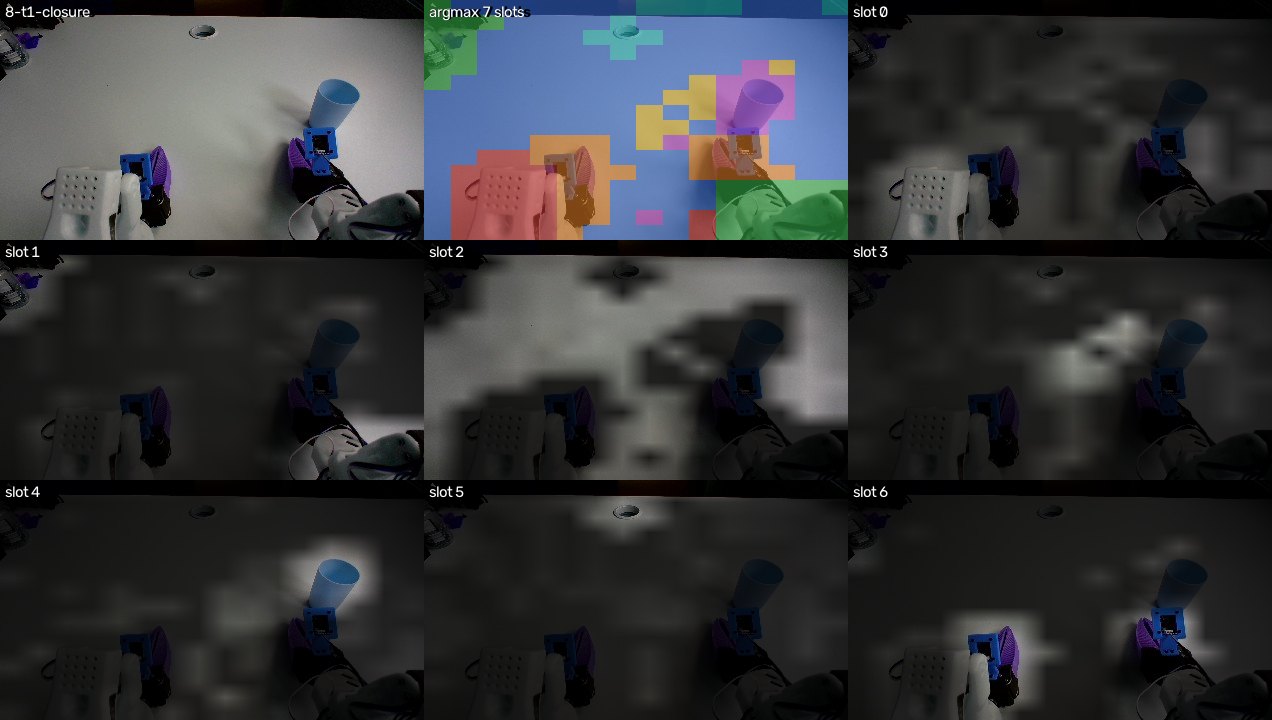


6. 判定与下一步
判定:B0 的输入端成立,但要按阶段理解。
关键在于策略什么时候需要「杯子在哪」这个信息——
是接近阶段,而那正是纯度 2.7×、slot 明显专注在杯子上的时候。
合拢之后杯子和爪子糊成一片不损失策略需要的信息:此时位置已经解决,腕部相机才是主力。
| 项 | 结论 |
|---|---|
| 耗时 | ✅ 通过 52.4 ms vs 预算 337 ms(本机实测) |
| 形状 | ✅ 正合适 7 个固定 slot × 256 维 → object_proj = nn.Linear(256, 960),N_obj 固定,不用 pad |
| 假阳性 | ✅ 不存在 无监督、不做「是不是杯子」的判断,没有阈值问题 |
| 覆盖 | ✅ 68–100%,中位 94%——杯子几乎总在某一个 slot 里 |
| 专注度 | ⚠️ 分阶段 接近阶段 2.7×(好),合拢阶段 1.2×(糊成一片,但此时不重要) |
| 提高分辨率 | ❌ 无效 518 更贵且多数帧更差 |
| slot 编号稳定性 | ⚠️ 不稳定 主导 slot 跨帧是 2,5,2,4,6,4,1,3,4。对 B0 不致命——7 个 token 全部 append、让模型自己挑,注意力不依赖固定顺序;但不能硬编码「第 k 个 token 是杯子」 |
下一步
- 进 T2:实现
object_proj+embed_prefix的 append 分支。att_mask必须标 1(开新块)并放在最后,否则会改写预训练特征——见 那一页第 7 节的证明 - 补测「和 SmolVLA 同时驻留时的耗时」——8 GB 统一内存会争用,52.4 ms 是单独跑出来的
- 先喂零向量跑通一步训练,确认形状和 mask 都对,再接真实 slot
另外一件和本判定无关、已经确定的事:
「贵的付一次、便宜的每帧跑」那个组合仍然成立——
开局用 OWLv2(1623 ms,对「cup」100% 精度)认出目标是哪一块,
之后用 FT-DINOSAUR(52 ms)跟踪它所在的 slot。
那个设计只要求 slot 的位置可跟踪(覆盖率中位 94%,够了),不要求它语义干净。
7. 证据等级
| 结论 | 等级 | 来源 |
|---|---|---|
| small@224 = 52.4 ms(p95 53.8,显存 152 MB) | 本机实测 | train310,N=50,预热 5 次 + cuda.synchronize() |
| small@518 = 262.5 ms,base@518 = 566.8 ms | 本机实测 | 同上 |
| 输出 7 个固定 slot,每个 256 维 | 本机实测 | 模型输出张量形状 |
| FT-DINOSAUR 没有任何语言接口 | 读过源码 | 全仓库无 text / prompt / tokenizer 通路 |
| 覆盖率 68–100%(中位 94%),纯度倍数 init 2.7× / closure 1.2× | 实测 | OWLv2 框 + argmax 归属,9 帧 |
| slot 有没有分出杯子 | 已人工判定 + 测量印证 | 操作者看完 12 帧,结论与独立算出的数吻合 |
| 12 帧里 3 帧没有杯子 | 实测 | OWLv2 @0.30,先由肉眼发现 |
| 518 不比 224 好 | 实测 | 同一批帧两个模型对比 |
| 和 SmolVLA 同时驻留时的耗时 | 未测 | 8 GB 统一内存,会争用 |
判定完成。B0 的输入端确认可行,下一步按第 6 节走。