不是更快的出酒机,
是会看着你调酒的调酒师
市面上的调酒机器人已经把「把酒做出来」解决得很好了。 我们要解决的是另一件事:让一杯酒的制作过程本身值得看。
Makr Shakr Veloce 的吞吐
行业区间 $30k–$100k+
和看着客人合在一起的系统
他们做得很好的那部分
先把话说清楚:现有系统不是做得差,是目标不同。 它们为吞吐量和一致性优化,并且达到了。
| 系统 | 形态 | 吞吐 | 价格 |
|---|---|---|---|
| Makr Shakr Toni | 双臂机器人(KUKA),158 瓶 | 80+ 杯/小时(官方页) | — |
| Makr Shakr Veloce | 双臂机器人,为速度设计 | 240 杯/小时 | — |
| Cecilia.ai | 屏幕形象 + 泵 · 语音对话 | 120 杯/小时 | $45,000 或 $2,000/月 |
| Yanu | 封闭机柜内机械臂 · 对话 + 支付 | 100 杯/小时 | — |
| MIXO 8 / 20 | 蠕动泵 | — | — |
| TendedBar / Backbar One | 转盘 + 泵阀 | 为高吞吐设计 | — |
整套装置是围绕机器设计的:杯子放在固定夹具上、瓶子接在固定管路上、动作走固定轨迹。 在这个前提下,预编程既快又稳。YouTube 上那些流畅的演示恰恰证明了这一点—— 那是它们的强项,不是短板。
Toni 的 80+ 是官方页数字;Veloce 的 240 来自媒体报道,另有二手来源写 250 —— 以官方为准,媒体数字标明来源。
产品官方图与详细市场分析见仓库内
04-reports/market-analysis/(未发布到公开站点)。但他们的「AI」在哪一层?
这是整份 pitch 的支点,而且它有原文出处。
预编程
“The recipe database contains pre-programmed ratios, sequences, and pour volumes.”
推荐与个性化
“machine learning tracks popular combinations, personalizes suggestions, and adjusts pours based on historical data.”
AI 用在「推荐喝什么」,不在「怎么动」。手臂本身仍然是一条录好的轨迹。
真正的空位在哪
会聊天的调酒机器人有了,会做动作的机械臂也有了。 但没有一台把两者放在同一个身体上。
还有一条横跨所有人的共性:无论会不会聊天, 它们的手臂动作全部是预编程的。AI 在推荐层、在对话层,就是不在动作层。 这是我们唯一真正的技术押注。
酒吧卖的从来不只是酒
如果只要液体,摇一摇预调罐更便宜。 人愿意坐在吧台前,是因为那里有人、有表演、有交流。
出酒速度
250 杯/小时。适合场馆、邮轮、机场——排队的地方。
被看着的那 40 秒
抬头看你、转动杯子让你看清颜色、把杯子推到你面前的那一刻。
交互本身就是产品
在不排队的场景里——精品酒吧、展会、门店——这一段比速度值钱。
所以我们不去和 250 杯/小时竞争。我们做那台会抬头看你的。
一次完整的服务,是四段
看那个橙点:视线在时序里出现两次,一头一尾,中间制作时是锁死的。 这不是设计偏好,是被数据逼出来的(第 10 页给证据)。
「知道客人在哪」是首尾两段的共同前提。 现有系统不需要它,因为客人必须走到取酒口去拿。而这恰恰是我们要换掉的那一步。
推出去,还是交到手上?
这两个选项听起来只差一点,技术难度差一个量级。
旋转完,推出
杯子始终留在桌面上,推向客人。
为什么可行:全程有桌面支撑;失败模式温和(推偏、推倒); 不需要判断对方接手了没有。
旋转完,拿起来递到手上
真正的人机递交。核心难点是放手时机:太早杯子掉,太晚人拽不走。
为什么卡住:人类靠触觉判断,而我们没有力/力矩传感器—— 观测里只有 17 维关节位置。
未验证 没有力觉时判断「对方接手了」只剩两条路,两条都还没试过: ① 从腕部相机看手有没有握住杯子——遮挡严重; ② 用舵机负载/电流——舵机能报,但它现在根本不在观测里,要用得先改录制管线。
这个取舍必须在录示范之前定。两种动作的示范数据不一样,录错了要重录。
这不是渲染图,是它真实的视野
下面四帧抽自我们已经录好的 50 集示范, 来自机器人头部相机的原始画面(424×240)。

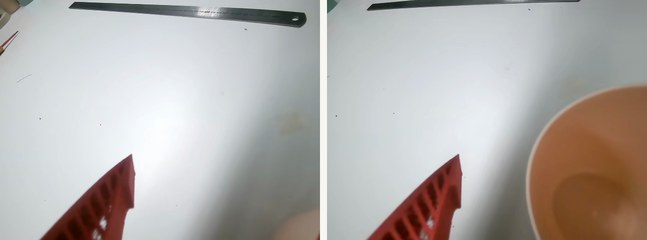
xlerobot-team/xlerobot-cup-grasp-20260820-0230,
50 集 / 19453 帧 / 30 fps。用 ffmpeg 从原始视频抽帧,未做裁剪或调色。三件和别人不一样的事
学出来的动作,
不是录好的轨迹
视觉-语言-动作模型(VLA)从人类示范里学。换一只杯子、挪一个位置, 靠泛化而不是重新示教。代价是它更难,而且必须证明有效。
情绪与对话
是一等公民
人脸检测 + 表情识别 + OLED 表情屏 + 语音,子系统已经在跑。 它不是加在最后的装饰,而是决定视线该看哪的输入。
面向观众的动作
旋转展示、朝人递出。这类动作在现有产品里不存在, 因为它们的客人是走过去自己取酒的。
关键技术选择:把画面按物体分组,再交给模型
不给模型喂「杯子在 (x,y,z)」这样一个我们手算出来的坐标, 而是把画面按物体分好组,让它自己决定该注意谁。 场景里同时有瓶、杯、人的时候,这个差别是决定性的。
已实测更正 这条路线在真正的 VLA 上有先例(Oat-VLA:token 256→16,LIBERO 上收敛快一倍)。 但 2026-09-04 在本机量下来,它的速度理由不成立:三路视觉合计只占总耗时 177.7 ms(13%),也就是说 token 全砍光最多省这么多, 而分割模型本身是个 ViT,省不下多少。速度理由已废;结构先验那条理由还在,但只有一个不显著的数字撑着。
跑在一块巴掌大的板子上
CPU 与 GPU 共用的全部内存
本地推理,不联网
我们的整机成本低一个量级
实测 双臂 + 可动头 + 三路相机 + 移动底盘。这块板子装不下 70 亿参数的模型—— 技术选择被算力真实地约束着。这不是缺点:它逼我们去找「更聪明」而不是「更大」的做法, 比如上一页那个把视觉 token 减少 94% 的路线。
为什么制作时视线必须锁死
「什么时候看客人」这个产品决策,最后是被一行数字定下来的。
head_2 σ = 0.0000 范围 [49.846, 49.846]
所有示范里,头一次都没动过。模型从来没见过「视线在移动」的画面。 制作过程中让头跟着客人转,输入就跑出了它见过的范围—— 它不会「稍微差一点」,而是面对一类它完全没学过的情况。
还有第二个独立原因:深度相机装在会动的头上, 它的标定是「头在某个姿态时」的标定。头一动,几何全废。
两个独立的约束指向同一个答案,所以「迎宾和递出时看人、制作时锁死」
不是我们挑的方案,是唯一能成立的那个。
好的产品决策常常长这样:不是选出来的,是被排除法剩下的。
我们怎么知道自己没在自欺
这一页在 pitch 里通常不会出现。我们放在这里,因为它是我们真正的差异。
每条结论标证据等级
实测 跑过,有输出 未测 没跑过
「没测过的推断」不许当成「测过的事实」讲。这条是被自己的错误逼出来的。
报区间,不报点估计
0/4 和 0/23 在表里长得一样,但真实成功率的 95% 上界差了四倍。见下图。
感知方案必须过人工看图
我们写过三个检测器,检出率 97.6%、抖动 6.4mm,数字全漂亮—— 看图才发现锁住的是机械臂自己。三次。
这条规矩也用在别人的论文上
Oat-VLA 报真机 59% vs 41%。我们用同一套方法算它给的原始计数: 29/49 vs 20/49,区间重叠,Fisher p=0.106,不显著。 所以我们引用它的 token 缩减,不引用它的成功率。
我们现在在哪:说实话
前面讲的是要去哪。这一页讲现在站在哪,包括不好看的部分。
- 双臂遥操作 + 数据录制(VR 和主从臂两条路)
- 50 集抓杯示范,30 fps,三路相机
- 人脸跟随 + 表情识别 + 语音对话(子系统已可运行)
- 关节级安全层:拒帧率从 96.6% 调到 0.49%
- 深度相机原生录制打通
- 抓取成功率 实测 8/83(95%CI 4.3–18.1%)
- 「可靠地框住杯子」还没做到——三次尝试都失败了
- 倾倒、摇晃、展示一集示范都还没录
- 相机内参和手眼标定没做
- 人脸子系统没有接到手臂上
我们把 8/83 写在 pitch 里,是因为这就是我们做事的方式。 一个说自己已经成功的机器人项目,通常只是没有认真数过。 我们数过,而且把置信区间也写出来了。
下一步,按依赖排序
| 要做的 | 为什么是它 | 要现场吗 | |
|---|---|---|---|
| 1 | 可靠地框住杯子(开放词表检测 + 人工看图核对) | 后面每个动作的共同地基 | 否 |
| 2 | 试验记录规范化:判据前置、失败模式、置信区间 | 不然分不清「改进了」和「运气好」 | 否 |
| 3 | 相机内参 + 手眼标定 + 头部预置位 | 任何 3D 推理的前置 | 是 |
| 4 | 迎宾段接通(手臂静止,视线跟人) | 不冲突、最先能演示的一段 | 是 |
| 5 | 录倾倒 / 展示 / 递出的示范 | 这些技能只能从示范里来 | 是 |
| 6 | 面向人的安全策略(独立设计,不改现有安全层) | 朝人伸手前必须先有 | 否 → 是 |
第 4 项值得单独说:迎宾阶段手臂是静止的,所以它不和任何东西冲突, 是整个产品叙事里最先能演示出来的一段——机器人抬头看着你、跟你说话、表情跟着变。 那已经是现有产品里没有的东西了。
最可能失败的三种方式
如果这个项目做不成,大概率是下面之一。写出来是为了能提前防。
抓取本身就没做起来
现在 8/83。如果「可靠地框住杯子」这一步过不去,后面倾倒、展示全都无从谈起。 这是首要风险,也是路线图第 1 项的原因。
示范数据不够教会「优雅」
倾倒的角度速率、停止时机,只存在于示范里。 视觉方案再好也不会让模型知道该倒多少。而这类示范我们一集都还没录。
算力吃不下
SmolVLA 一次推理 1329 ms,规划 50 步动作 —— 在 30 Hz 回路上等于 1667 ms 的动作, 预算用掉 80%,只剩 337 ms 余量。再加一个每帧都要跑的检测模型,余量就没了。
三条都有对应的第一步,而且都是纯远程、不占机器人时间的: 离线跑检测 + 人工看图(风险一)、先量一次展示动作的关节速度再录(风险二)、 量一次 token 减少的净收益(风险三)。都可以在下一批示范开录之前做完。
一句话
现有的调酒机器人把客人当成取酒的人。
我们想做的这台,把客人当成看的人。
这个区别决定了每一个技术选择: 为什么要学习式的动作而不是录好的轨迹,为什么视线控制要按阶段切换, 为什么第一版做「推出」而不是「递到手上」,以及为什么我们把 8/83 写在 pitch 里。
本页所有带「实测」标记的数字都可以在仓库里复现;带「未验证」的都还没有跑过。
竞品官方图与详细市场分析在仓库内
04-reports/market-analysis/,未发布到公开站点。