English version →
XLeRobot · Robomates · 2026-09-11
不是更快的出酒机,
是会抬头看你的调酒师
现有调酒机器人把「把酒做出来」解决得很好。我们做的是另一件事:让制作过程本身值得看——而且这一版,手臂的动作是学出来的,不是录好的。
6 / 6右臂抓杯,2026-09-11
补录数据后首轮,单只训练杯
15 / 20左臂抓杯,2026-09-09
28 批实机试跑的最好一组
数字出处:05-training/trials/trials-20260911-152009.json · STATUS.md(gen_status.py 生成)· 第 2 页逐家拆开第三项。全部为实机运行、可复现。
01 · 缺口
他们的 AI 在推荐层,不在动作层
Makr Shakr 240 杯/小时、Cecilia.ai $45,000、Yanu 封闭机柜:为吞吐和一致性优化,并且做到了。整套装置围绕机器设计——杯子在固定夹具、瓶子在固定管路、动作走固定轨迹。
动作层 · 预编程
“The recipe database contains pre-programmed ratios, sequences, and pour volumes.”
AI 层 · 推荐
“machine learning tracks popular combinations, personalizes suggestions, and adjusts pours based on historical data.”
会聊天的调酒机器人有了,会动的机械臂也有了,没有一台把两者放在同一个身体上,而且所有手臂都是录好的轨迹。杯子挪 5 cm,同一条轨迹就抓空。
引文:sedonatec.com · 官方页 makrshakr.com/toni、cecilia.ai、yanu.ai。「官方页无相关描述」不代表没有此能力,只代表没有把它当卖点。
02 · 产品
一次服务是九段,视线出现两次
01 · 视线在客人身上
迎客:抬头看人 + 打招呼
看到人脸才开口。手臂不动,所以这一段最先能演。
02
点单:复述 + 等确认
唯一通往手臂动作的闸。解析出的订单只是提案,人说「是」才算数。
03
右臂抓杯(SmolVLA)
低头到 cup-grasp-v0。退出时保住力矩——它手里有一只罐子。
04
左臂抓杯(SmolVLA)
左臂干活时,右臂靠力矩保持姿态。
05
右臂 → place,不松爪
硬编码。place_pose.right;夹爪不动。
06
左臂 → place,不松爪
硬编码。place_pose.left,10 集示教出来的。
07
左臂 → pour 端住
硬编码,--from-grasp:全程不张爪。
08
右臂 → pour 并倾倒
wrist_roll 3.2° → 76.7°。倒酒就发生在这一步。
09 · 视线回到客人
左臂递给客人
按实测的人脸方位递出,不是写死的取酒口坐标。
一条总线
同一时刻只跑一个阶段,跑的时候其余按钮全禁用。策略进程和脚本阶段都要占两条串口总线。
力矩接力
阶段之间手臂手里是有东西的,所以每一段退出时都保住力矩。松掉力矩,饮料就落地了。
没有「一键全跑」
故意不做。每一段之间都要有人看一眼——这就是逐段手动按钮的意义。每个实跑阶段都从头相机录像存档。
第 03 段 · 抓杯——手臂伸出、闭爪、把杯子提起来。取自一次不剪的 79 秒连续跑,2 倍速。
第 09 段 · 递出——把杯子送到客人所在的位置,端着等他拿走。同一次跑、同一条录像,2 倍速。从下单到这一帧,没人碰过机器人。
 上海,我们 2026-09-12 现场拍的。左:门头「DQ · sharpa · 24 小时营业 · 预约体验入口」,门口有人等。中:门口的预约指南——扫码预约、选择时间、查看预约、到店核销;「没排上?每周五六 10:00 开放下一周预约」。右:我们在店里拿到成品,背后机器人正在做下一单,屏幕写「启动任务规划引擎,进入暴风雪制作流程 · 步骤 STEP 01/55」。
实地见闻 · 上海 · 2026-09-12
只做一样东西的机器人,预约排到下周
一家 DQ 门店,玻璃后面是 sharpa 的人形机器人。它只做一个产品——暴风雪。而且不能直接进去买:得在小程序上预约,下一周的号周五、周六 10:00 放。我们去的时候现场人满为患。
一种口味、55 步写死的流程、动作不是学的、也没有视线——它照样能排队,照样养得起自己占的那块地。「被看着的那 40 秒」值钱,这件事已经有人替我们证明了。它同时也是这条路的天花板:每次演的是同一出,机器人从不抬头看人。我们这版会看着客人,手臂的动作是学出来的,不是录下来重放的。
证据等级:我们自己 2026-09-12 现场拍的照片和视频——上面那条就是原始素材,招牌和屏幕文字是从画面里逐字抄的。「人满为患」「受欢迎」「赚钱」是当天的主观印象;没有记客流和营收数字,运营方也没有公开数据。
酒吧卖的从来不只是液体。人坐在吧台前,是因为那里有人、有表演、有交流。现有系统优化出酒速度,适合排队的地方;我们优化被看着的那 40 秒,适合精品酒吧、展会、门店。
九段来自 brain/run_bimanual_sequence.py:STAGES,从 8796 序列面板一段一段手动按;第 1–2 段是 brain 状态机(state_machine.py 的 GREETING / CONFIRMING),3–4 段是 SmolVLA,5–9 段是硬编码。每一段都有自己的头相机录像,存在 replay-20260912/。上面两段动图取自 2026-09-12 的同一次不剪连续跑。把九段连成不断的一条,是第 11 页第 3 周那条承诺。
03 · 头
头就是界面
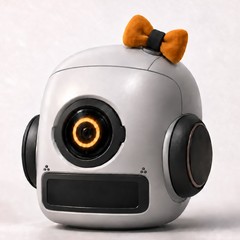
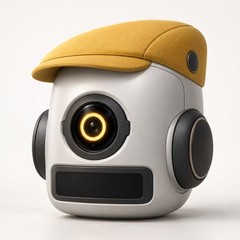
V14 头的动态渲染:转头、点头、眼睛表情。单只 LED 环眼;下方那道宽窗就是深度相机;两侧是圆耳罩。
同一颗头,换一身行头。帽子和蝴蝶结是可换外壳,固定件——相机、眼、耳罩、立柱禁区——一个数不动,所以换造型不会动标定。可打印 STL 已出。
员工牌上有两位调酒师——同一个身体
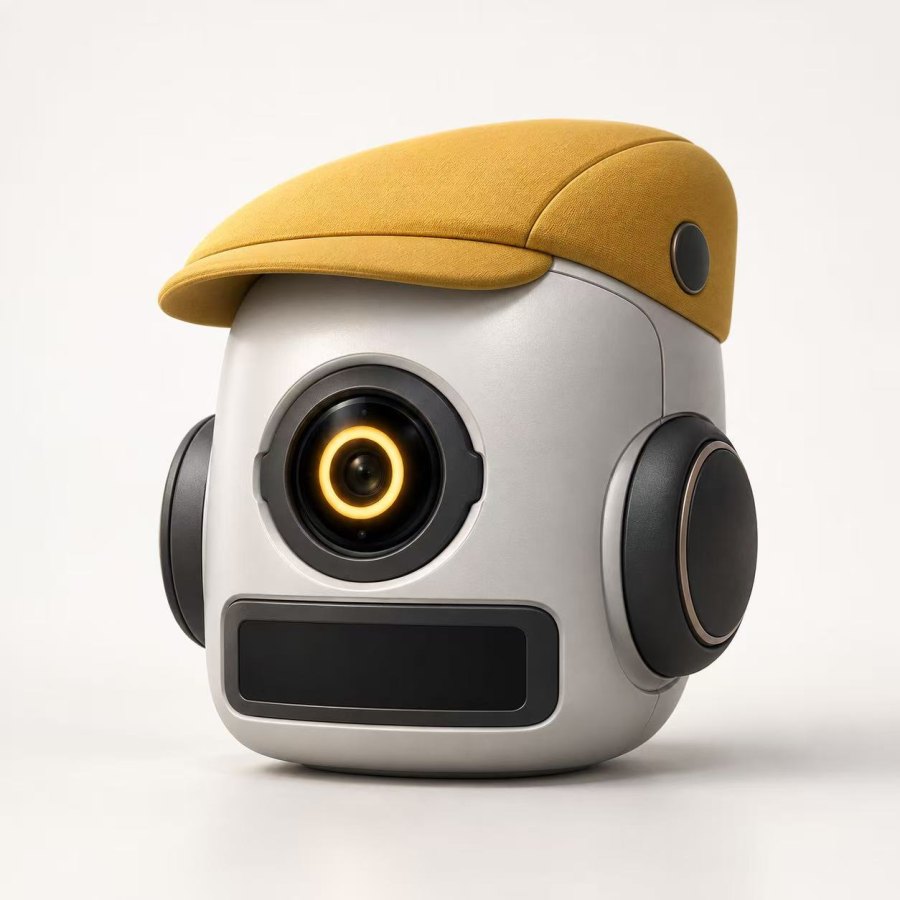
Barley
首席调酒师 · 暖场班
热情、嘴快、有点傻气。一次只说一两句,话没说完手已经伸向杯子;去拿酒那段的台词,要拿客人点的那杯做文章。
调侃酒,不调侃客人。从不提价钱。
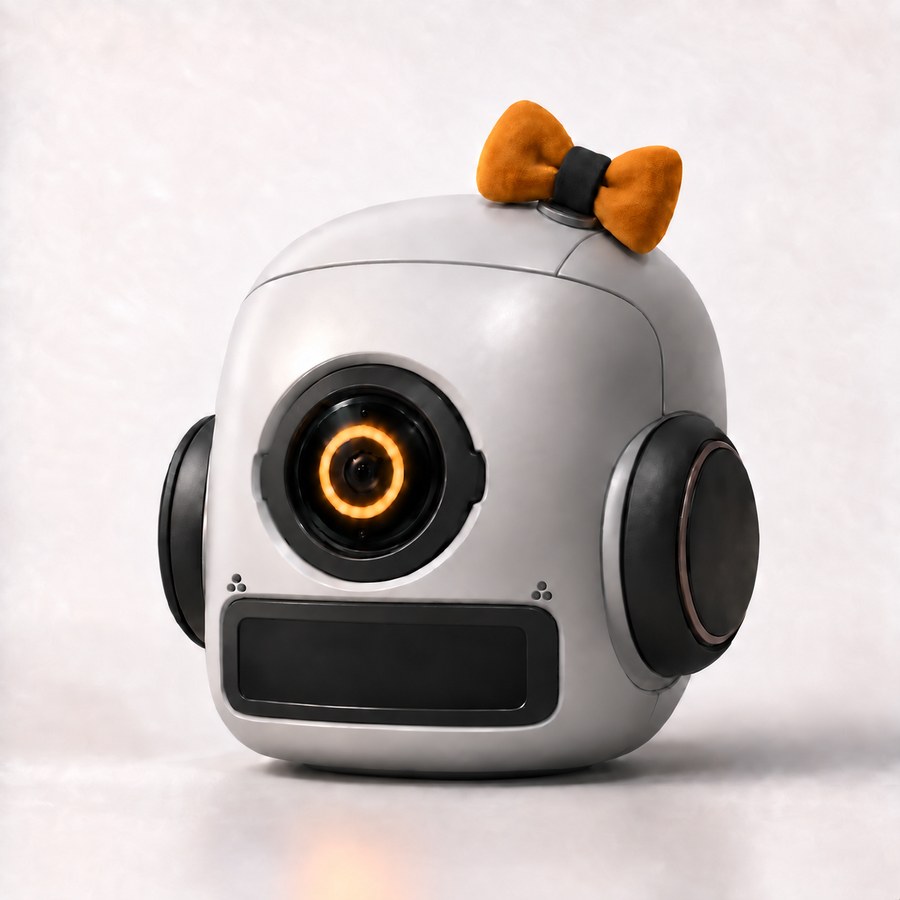
Cyborg
值班调酒师 · 冷场班
它会听客人闲聊——只是不陪你往云上飘。客人一开始抒情,它就把话拽回地面:「这不是一个哲学问题。」
冷、干、务实,但它一直在听。两个温度,同一个身体。
在这里,一个调酒师就是一个文本文件。换掉文件就是换掉调酒师,头上的行头跟着换。这就是同一台机器既能进精品酒吧、又能上展会展台,而不用重做任何东西的原因。
为什么要一颗头
「看着客人」需要一个能转的视线和一张会变的脸。视线在迎宾和递出时看人,制作时锁死。
锁死是被数据定的
54 集示范里头部两个自由度标准差 0.0000——模型从没见过「视线在动」的画面。深度相机装在头上,头一动标定全废。
工程约束
pan 范围 342–3754 由深度相机线缆决定;标准视角 cup-grasp-v0 = pan 2003 / tilt 2617,每次开跑先对头、看图确认。
02-hardware/robot-head/v13-frame-first(STL、打印说明)· configs/head_presets.json · brain/check_head_pose.py · 人格文件:03-software/conversational_ai/roles/barley.md 已写好;cyborg 那版还在改——roles/robot.md 里现在仍是旧的「自动调酒单元」写法。眼窝背板在当前网格里缺失,打印前看 STL-README。
04 · 证据
我们修的是数据,不是代码
右臂模型 09-08 实机 0/14。诊断:40 集示范里杯位覆盖失衡 16 倍(最密档 16 集,最疏档 1 集),模型学的是节奏不是视觉——闭爪时刻和杯位的相关只有 r = 0.16–0.26。
0 / 142026-09-08 · 0826 数据集 40 集
chunk auto · 60 s
73 集09-08 按录制指南补录 33 集,合并
杯位五档各 ~11 集,覆盖变异系数 0.84 → 0.37
6 / 62026-09-11 · 同一训练配方一字不改
chunk 1 · 60 s · 95% CI 54–100%
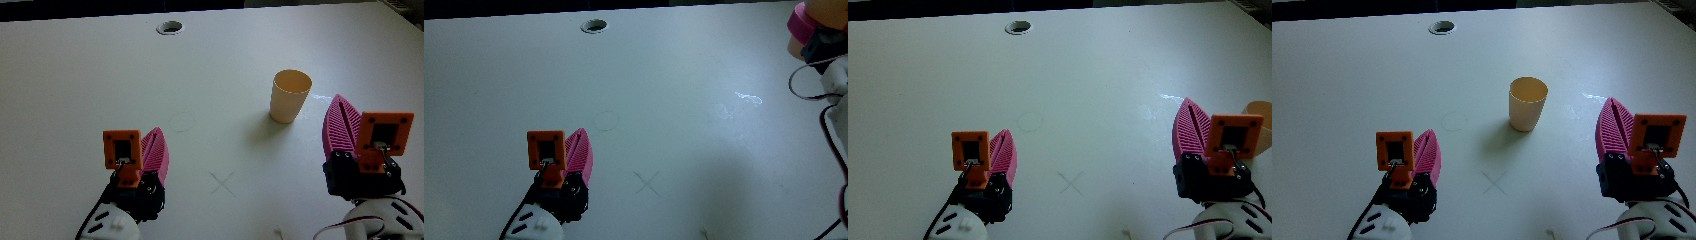 2026-09-11 右臂 6/6 那轮,第 1、3、5、6 集闭爪时刻的头相机画面(策略实际看到的分辨率 424×240)。
2026-09-09 左臂那一轮的自主抓取片段,拼成 2×2 / 4×4 / 5×5 动图,6 倍速——画面角标写的是「每格一次真实自主抓取」。那轮 28 次实机里最好的配置是 15/20。素材来自左臂;上面的 6/6 是右臂。
train_config 与上一版 145 项全同,只换数据集。出处:train-right-0826sep8-2026-09-10、recording-guide-2026-09-08、trials-20260911-152009.json。void 2 集(一次未摆杯、一次杯位超范围)不进分母。
05 · 它真的在看
不是录像回放:它会在推倒杯子之前改主意
操作者现场记录 · 2026-09-11 第 5 集
「差点要把杯子推出去,推之前调整了,非常聪明。」
第 8 集
「一开始有点把杯子往外推,但马上调整把它抓起来了。」
第 5 集,抓到之前那几秒。头相机画面,2 倍速,裁到爪子周围。爪子先贴到杯子上、把它蹭了一下,然后退开、换个角度再进。
第 8 集,同一个时刻。杯子一开始在爪口外面,被往外推了一点——手臂是跟着它走,而不是对着空气闭爪。两段都取自 6/6 那一轮,除了变速和裁切没有剪辑。
这就是闭环的样子:抓歪 → 看到 → 修正。一次完美运行证明不了什么;一次纠错证明它在看画面。
有广度,不是撞上一次
两条手臂加起来 49 次实机跑有记录。左臂 2026-09-09:28 次跑、4 种物体,最好配置 15/20。右臂 2026-09-11:在训练过的那只杯子上 6/6——然后同一个 checkpoint、没有重训,在从没训练过的杯子和杯位上 3/8、1/5,位置横跨 −40° 到 +14° 的八个档。
这三个数分开摆着,没揉成一个好看的平均数——这正是第 8 页那条计数规矩在起作用。而分开摆,它们才说出有用的事:熟的场景稳,生的场景是衰减不是归零,而且边界指得出来。跑通一次的机器人谁都能给你看。
舞台上只做一个动作
当众把杯子挪 10 cm,让它重新找到。观众从头到尾的疑问是「这是不是提前编好的」,这一下回答完毕,执行成本为零。
05-training/trials/cup-positions.json(逐集杯位与操作者观察)· 00-admin/DEMO-STRATEGY.md「惊喜点排序」第一条。
06 · 选杯
小模型怎么做到「选」:把选择放在模型前面
训练集每帧一只杯、一句话。桌上放两只,它往中间伸(09-11 三次);指令加 yellow,轨迹变乱,目标不变。SmolVLA 4.5 亿参数、板子 7.4 GB,要教它「按词选杯」得重录再训一夜,而且没有先例保证学得会。
 夜间帧,2026-09-12。上:两个不该被追的东西——笔筒、一只侧倒的杯子——被框出来。下:两处都用框外一圈的中位色填掉,只改策略的输入。交到策略手里的画面里只剩一只杯子。
夜里那轮跑出来的东西 · 2026-09-12
原则从「按颜色点名抹掉一只」改成「只保留一个,其余全抹」。桌上多一个干扰物,不该要改一次配置。
在 25 帧评测集上,我们 09-11 白天量的那套颜色阈值只检出 1/25。夜里桌面和杯子的饱和度一起掉到 10–30,颜色根本不再是可分特征。按「限定桌面区 + 相对桌面亮度」重做之后:15/25。
夹爪也不能按颜色排除——米色杯和橙色支架的色相带完全重合(都在 H 8–30),排掉橙色就等于把杯子一起杀掉。改成按位置排:两条手臂永远从画面左下和右下进来。
还有一条:本来打算拿「空桌底片」去盖干扰物,实测发现那张底片并不空——那个位置当初摆着一只绿杯,盖上去等于往画面里塞一只不存在的杯子。改用中位色填充:不依赖底片、不引入形状、跟着当前光照走。
取舍
选择不进模型。头相机画面里除了选中的那只杯,桌上其余杯状物全被抹掉、用框外一圈的中位色填回;策略看到的就是它训练过的单杯场景。
代价
一帧 3.3 ms(424×240,CPU),控制周期的 3%。同一个 checkpoint 不动,换指令只换掩膜颜色。
为什么是优点
小模型的泛化用在它擅长的「抓」上;「抓哪只」是个 3 毫秒的经典视觉问题,不值得一夜 GPU。
实测25 帧真实头相机画面、白天加夜间:09-11 那套颜色规则检出 1/25,重做后的检测器 15/25。新增两条通道——--mask-keep(只留一只,其余全抹)和 --mask-box(按位置抹掉矩形)。管线里已按订单切换跑通,3 ms/帧。左臂模型上 8 集探索显示它无论抹哪只都去蓝杯——左臂模型自带偏好,不能当测试台。未测选杯准确率——要在右臂模型上预注册「抹蓝抓黄 / 抹黄抓蓝」各 5 集,判据写死为「闭爪时 pan 落在目标杯一侧」。2026-09-12 那组对照实验不算数:抓取区里根本没有目标杯,两轮 held=0 是必然的,2% 的安全层差异也在单次试验的噪声量级。要有意义,得桌上同时摆一只目标杯和一只干扰杯,而且需要有人在现场摆。
scripts/cup_mask.py · scripts/cup_mask_eval.py · run_policy_trials.py --mask-keep / --mask-box · maskeval-20260912/README.html(25 帧评测集、三次检测器尝试、对照实验,2026-09-12 夜写的)· cup-colour-mask-2026-09-11.html。检出率是 60% 不是 100%,漏的集中在比桌面亮的杯;夜里 classify() 读不出颜色,--mask-keep 退回「留离横向中心最近的那只」,按颜色选杯不可靠;桌面区是按 cup-grasp-v0 这个头位标的,换场地要重标。
07 · 远程
从 7,000 公里外操作,是功能不是借口
团队在中国,机器人在芬兰。2026-09-11 整天的试跑、判定、数据记录都是远程完成的:面板起任务、操作者现场摆杯按确认、结果自动归档。
三个地点,一台机器人。手臂在赫尔辛基;起跑、判定、写记录的人在 7,000 公里外的杭州和台湾。这份 deck 上没有一件事需要有人坐飞机。
闭环
遥操作 → 示范录制 → 数据集 → 云端训练 → 自主执行 → 人接管。这一整环 2026-09-11 当天全部跑过。
三条通路
VR 头显遥操作、主从臂录制(8781)、8770 面板试跑与控制。Tailscale 直连,随机器走。
商业含义
一个远程团队可以同时照看多台机器:现场只需要一个人摆杯、按急停。
robot_server.py(8770)· leader_follower_server.py · vr_teleop.py · 00-admin/ROBOMATES-DEMO-DAY-HANDOVER-2026-09-10.md。
08 · 方法
安全层和数数的规矩
安全
- 关节级安全层:地板按夹爪俯仰角算,拒帧率 96.6% → 0.49%
- 过热保护:50 °C 警告、60 °C 停机,每拍读一颗
- 软件急停、双总线互斥、每帧整体原子
数数
- 每条结论标证据等级:实测 / 未测
- 报区间不报点估计(Clopper-Pearson)
- k/n 按配置分组:模型、数据集、夹爪、chunk、时长、杯位,任一不同就是另一组
- 预注册:判据、次数、void 规则跑前写死;没预注册的只算探索
为什么要费这个劲。不是谦虚——是为了让有意思的那些话说出来有人信。第 5 页那三个数就是这套规矩的产物:6/6、3/8、1/5,分开摆着,而不是揉成一个既讨好我们、又什么都没告诉你的平均数。
policy_safety.py · thermal_guard.py · ROBOTIC-WORKING-HANDBOOK.yaml(V-01、V-04)· STATUS.md。
09 · 硬件与成本
跑在一块巴掌大的板子上
$660XLeRobot 整机公开物料成本
(上游 README)
7.4 GBJetson Orin Nano,CPU/GPU 共用
策略加载后仍剩 >3 GB,全部本地推理
低两个量级相对 $30k–$100k+ 的
现有商用调酒机器人
双臂 + 可动头 + 三路相机 + 移动底盘。这块板子装不下 70 亿参数的模型——所以选 4.5 亿参数的 SmolVLA,把「选杯」这类问题交给 3 毫秒的经典视觉(第 6 页)。约束逼出的是更聪明的做法,不是更大的模型。
~/XLeRobot/README.md($660)· 本机 free -m 实测 2026-09-11。
10 · 边界
诚实的边界,每条后面跟着下一步
| 今天做不到 | 证据 | 下一步 |
|---|
| 桌上两只杯,它往中间伸 | 09-11 三次,trace 可查 | 掩膜路线 5+5 预注册;或补录 50 集带颜色指令 |
| 左臂模型只抓右侧那只蓝杯,不管看到什么 | 09-11 四种条件 + 抹图 8 集一致 | 颜色实验改在右臂模型上做;左臂补录带两杯的数据 |
| 右臂对别的颜色的杯子有点不认得 | 蓝 1/2、粉 0/1、绿罐 0/1:到位不闭爪 | 同上,或掩膜把它变回训练杯场景 |
| 按语言选杯 | 加 yellow 的 A/B,目标不变 | 同上 |
| 倒酒是脚本,液体不上台 | pour_cup.py,09-09 真机一次 | 接进状态机 POUR 态;演示用空杯 |
| 换桌子 | 桌高差 3 cm 策略作废 | 搬场地流程已写:肩轴到桌面复现到 ±1 cm |
| 左肩舵机过热 | 50 °C+ 欠力 6–7° | 换舵机后全套重标 |
cup-colour-mask-2026-09-11 · venue-move-2026-09-11 · NOTE-MODELS-RIGHT-ARM-POURING-2026-09-11。
11 · 如果选中我们
选中之后的四周,我们会拿出这些
这是承诺,不是愿望清单。下面每一条都写了「算不算做到」的判据,每个结果都会带日期和 k/n 发到公开报告站——做砸的那些也一样发。你不需要信我们的口头描述。
✓ 已经做到:迎宾 → 抓取 → 递出,一次连续跑、一个进程,中间没人碰过机器人,有不剪的录像。
-
第 1 周 · 技术
把颜色指令数据补齐
50 集,黄蓝各半、位置对调,和单杯数据集一起训。判据:数据集公开,杯位五档的覆盖变异系数报出来。
-
第 2 周 · 技术
跑一轮预注册试跑,跑成什么样报什么样
判据、集数、void 规则在跑之前写死,然后按第 8 页的规矩判。判据:k/n 公开——6/6 还是 3/10,都上同一页。
-
第 3 周 · 产品
做真正需要「调」的酒
倒酒进管线:POUR 状态 + pour() 执行器。现在可乐、芬达、雪碧、水是同一个物理动作的四个名字,这一步终结它。判据:至少两款两种以上配料、按配方依次倒的酒,端到端跑通并有录像。
-
第 4 周 · 产品
不是一次,是每次
同一配置连续跑 10 次,全程没人伸手;递出方向取自实测的人脸方位,不是写死的坐标。判据:这 10 次的 k/n 按同一套规则公开。
-
第 4 周 · 商业
摆到真实人群面前
新场地走 10 步进场流程,从箱子到能跑 2 小时;谈成并到场至少一场鸡尾酒活动或酒吧周;当晚现场收反馈。判据:活动办成了,反馈整理成文公开、说什么发什么;一家有名有姓的场地书面说明「要满足什么条件才愿意摆进店里」。
我们不承诺什么
不承诺成功率。第 8 页那套计数规则不会为了好看而改:k/n 按配置分组、绝不合并、void 的试跑写清楚并剔除、每条结论标证据等级。如果颜色指令那轮跑出来是 3/10,报告上就写 3/10,和 6/6 放在同一页。
优先级:演示可靠 > 技术讲得清 > 一个明确的客户故事 > 看得见的投入。所有东西边做边发在 suyang99-xlerobot-build-reports.static.hf.space;仓库历史就是审计线索。
12 · 结尾
现有产品把客人当取酒的人。
我们把客人当可以互动的人。
这个区别决定了每一个技术选择:为什么动作要学出来而不是录好,为什么视线按阶段切换,为什么把「选杯」放在模型前面,为什么每个数字都标出处。
Barley 正看着你。一只眼睛,而且它会转过来——上面那句话的全部差别就在这里。
XLeRobot · Robomates · 2026-09-11 · 本页所有数字均可在仓库中复现。代码与数据:github.com/ginagina19992023/Robotic_challenge · 报告:suyang99-xlerobot-build-reports.static.hf.space